 VPSbit
VPS con protección DDoS explicado: qué cubre realmente el filtrado
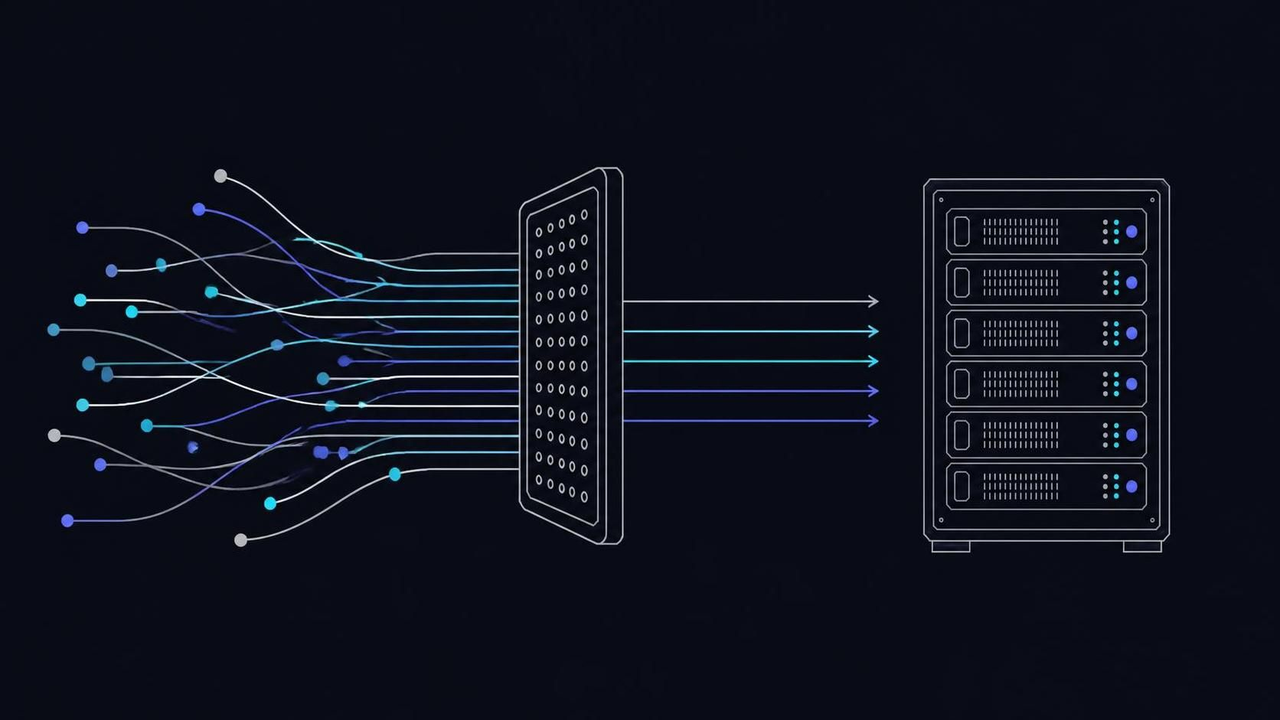
Todos los planes incluyen scrubbing L3/L4 sin coste; las inundaciones L7 siguen siendo cosa tuya. Qué absorbe Core por $6/mes y dónde entra tu aplicación.
Todos los planes incluyen scrubbing L3/L4 sin coste; las inundaciones L7 siguen siendo tu responsabilidad con límites de tasa. Qué absorbe Core por $6/mes y dónde toma el relevo tu aplicación.
Los nombres de los ataques son nombres de capas
La mayoría de las discusiones sobre protección DDoS miden la capa equivocada. Un escudo que absorbe la inundación volumétrica más grande registrada puede aun así ser derribado por unos pocos miles de conexiones HTTP pacientes, porque los dos ataques no viajan por la misma capa. Las inundaciones L3/L4 — tormentas de SYN, amplificación UDP, abuso de ACK — apuntan a tu tubo y a tus tablas de estado, y los centros de scrubbing de tránsito las tragan por el camino. Las inundaciones de aplicación llegan disfrazadas de peticiones legítimas, y ningún filtro de red puede separarlas de los usuarios reales sin conocer tu aplicación.
Los nombres de las capas son el mapa. Todo lo que está por debajo de HTTP se responde antes de que un solo paquete llegue a tu host: los centros de scrubbing de upstream comparan el tráfico con perfiles de volumen y protocolo y descartan la basura en tránsito, en todos los puertos, no solo en el 80 y el 443. Las mitigaciones son antiguas y bien conocidas: la RFC 4987 cataloga las defensas contra SYN-flood que todo stack moderno trae por defecto hoy en día. Heredas todo ese trabajo sin configurar nada, y precisamente por eso vale la pena saber dónde se detiene.
La capa 7 es otro animal. Un slowloris mantiene sockets medio abiertos; una inundación de API reenvía peticiones firmadas válidas tan rápido como tu endpoint las acepta; una tormenta de cache-miss obliga a la base de datos a recalcular la misma página para cada visitante. Cada petición es legal por separado, así que la red las entrega todas sin rechistar: un filtro que deja pasar el tráfico legítimo no puede rechazar tráfico que parece legítimo. La taxonomía de denegación de servicio de la RFC 4732 lo dice sin rodeos: agotar los recursos de un servidor rara vez requiere ancho de banda.
El error que esto provoca es leer un banner de «DDoS incluido» como una garantía de aplicación. Es una garantía de red: el tubo y la maquinaria de estado sobreviven, y todo lo que tenga forma de petición es asunto de tu rate limiting, tus timeouts y tu caché. Cuando un operador dice que la protección falló durante una caída, el informe del incidente suele mostrar una inundación con forma de aplicación pasando junto a un filtro intacto. El resto de esta guía traza esa frontera con precisión, para que sepas de qué mitad de la defensa eres responsable y dónde invertir tu próxima hora.
VPS desde $4.80* (plazo anual), almacenamiento 1–5 TB NVMe desde $24/mes equivalente anual, dedicados con IPMI desde $4.809.20/mes. Factura en cripto, sin KYC.
Lanzar ahoraQué viene con todos los planes y qué cuesta aparte
El filtrado no es una función adjunta a tu plan; es una propiedad de la red sobre la que el plan se asienta. Esa distinción importa al comparar catálogos, porque un host que vende protección por IP te está vendiendo un interruptor, mientras que un host que hace scrubbing en upstream no tiene ningún interruptor que activar. Aquí, el filtrado L3/L4 viene activado en todos los SKU de VPS y dedicados: sin cuota por IP, sin ticket de soporte, nada que encender después del aprovisionamiento. La cuenta de debajo sigue siendo los mismos dos campos: un email o token más una contraseña de 12 caracteres, como recoge la página de requisitos y límites.
La escalera de metal añade una capa propia. Los niveles dedicados llevan el mismo filtrado volumétrico más acceso IPMI — consola y alimentación fuera de banda —, que es la diferencia entre reimagenar tú mismo una máquina bloqueada en minutos y esperar un turno de soporte que conecte una KVM. En la cima, Monolith combina su plataforma dual-EPYC con un scrubber L3/L7 en el uplink de 25 Gbps: el único SKU donde el scrubbing de capa de aplicación forma parte del hardware y no de tu stack. Todo lo que queda por debajo es solo de red por diseño.
El dimensionamiento es donde decides a qué protege el escudo. Pide Core por $6/mes ($4.80/mes en el término anual) y el filtrado lo acompaña idéntico que al nivel dedicado más grande: el plan compra cómputo, la red aporta el escudo. Core lleva un puerto sin límite de tráfico de 1 Gbps, 4 GB de DDR5 y 80 GB de NVMe, de sobra para un servicio que se sitúa tras el filtro. Si la carga está expuesta a la web y es frágil, gasta la diferencia en una CDN antes que en un puerto más grande.
Dónde se rompe esto: asumir que la capa incluida te sigue fuera de la plataforma. El scrubbing existe en el tránsito de esta red: mueve el mismo servidor a un proveedor de ofertas y lo mueves fuera del filtro, en pleno incidente, en el peor momento posible. El segundo error es tratar el scrubber de Monolith como motivo para comprar metal para un blog; el remedio honesto para un sitio pequeño es rate limiting más una caché. Con media plataforma mapeada, la siguiente variable es la que sí puedes cambiar: cuánto tráfico limpio puede llevar tu puerto.
La velocidad del puerto es tu techo de tráfico limpio
Un puerto sin límite de tráfico suena a tubo infinito, y esa lectura es exactamente la equivocada durante una inundación. Sin límite significa que nadie mide tus bytes; el techo sigue siendo el propio puerto, y el techo que importa es el tráfico limpio: el ancho de banda que queda después de que los filtros de upstream terminen de descartar basura. Cuando un ataque satura lo que queda, los usuarios sufren timeouts aunque cada paquete malicioso haya sido descartado; por eso elegir el puerto es una decisión de mitigación y no un detalle de facturación. Reservas, ráfagas y paneles miden aquí la magnitud equivocada: la cifra operativa es cuánta demanda legítima puede servir el puerto mientras los filtros de upstream están ocupados.
La escalera del catálogo es corta. Los planes VPS de entrada llevan 1 Gbps sin límite de tráfico; Prime sube a 2.5 Gbps; Titan corre a 10 Gbps; los niveles dedicados van del 1 Gbps de Forge al 25 Gbps de Monolith. Esas cifras son techos en el peor caso para el tráfico que realmente llega al host. Los ataques volumétricos mueren en upstream, así que lo que aterriza en el puerto es el residuo — pero un atacante decidido con más capacidad que tu enlace puede apagar un servicio de 1 Gbps desde cualquier punto del planeta; por eso la capacidad es también una cuestión de arquitectura.
Dos palancas cambian la ecuación. La primera es la ubicación: el mapa abarca doce ubicaciones, y la calidad del peering en el centro de datos — AMS-IX en Ámsterdam, DE-CIX en Fráncfort, HKIX en Hong Kong — decide cuánta porquería absorben los niveles de upstream antes de que tu puerto vea nada. La segunda es el apetito de la aplicación: un servidor de juego con whitelist de la comunidad presenta una superficie mucho más estrecha que una instalación de WordPress abierta, así que el mismo puerto sobrevive a una lista de atacantes más larga para una carga que para la otra.
El error típico es ampliar el plan en pleno ataque en lugar de poner HTTP detrás de una CDN. Un puerto más grande sube el techo por un factor; una caché delante del sitio elimina por completo la aplicabilidad de la inundación, y cuesta menos que la mejora. Compra capacidad para crecimiento legítimo, no para el cálculo del atacante. Con el tubo dimensionado con honestidad, lo siguiente que hay que dimensionar es la tabla que rastrea cada conexión que tu servicio acepta — y esa vive en el kernel.
La tabla de estado es la verdadera primera línea
Los ataques baratos apuntan a la memoria, no al ancho de banda. Cada conexión TCP que tu servidor rastrea ocupa memoria del kernel, y una tormenta de SYN que nunca completa un handshake obliga al stack a retener entradas medio abiertas hasta que los timeouts las limpien; así, una botnet modesta puede agotar los valores por defecto dimensionados para un ordenador de sobremesa. El agotamiento de estado, no la saturación del tubo, es como aterrizan la mayoría de los ataques pequeños: el kernel es el objetivo, y el kernel es donde se ajusta. La buena noticia es que Linux expone todos los parámetros relevantes en un solo directorio.
Los parámetros viven bajo /proc/sys/net/. El rastreador de conexiones se autolimita en nf_conntrack_max; el backlog de SYN lo gobierna tcp_max_syn_backlog; la cola de escucha que una aplicación puede siquiera solicitar está acotada por net.core.somaxconn. Las SYN cookies — tcp_syncookies — permiten al stack responder a las tormentas sin almacenar estado por conexión, técnica que documenta el manual tcp(7) junto con las variables de ajuste. Sube las colas antes del ataque, porque redimensionarlas durante uno compite con la inundación por la misma CPU que intentas defender.
El orden de dimensionamiento importa tanto como los valores. Ajusta somaxconn para que coincida con lo que la aplicación realmente pide con su listen backlog, y luego sube tcp_max_syn_backlog y nf_conntrack_max a cifras que la RAM pueda pagar: un VPS de 4 GB sostiene cientos de miles de entradas de rastreo sin despeinarse, y el metal dedicado con ECC sostiene millones. Durante una inundación de prueba, vigila los contadores bajo /proc/sys/net/netfilter/ y verás qué tabla se llena primero; esa tabla, y no la gráfica de ancho de banda, es la verdadera historia del incidente.
El fallo clásico es un kernel ajustado a lo ancho detrás de una aplicación que escucha con un backlog por defecto: las conexiones sobrantes completan el handshake y luego se apilan en userspace, donde el pool de trabajadores, y no el kernel, se convierte en el cuello de botella. Ajusta ambos lados o el ajuste es teatro. La misma idea tiene primos más viejos: pf en BSD la expresa como límites de estado en pf.conf, y cada firewall comercial es el mismo concepto detrás de una licencia. Resuelta la capacidad del kernel, cualquier inundación que quede llega vestida con la ropa de tus propios usuarios.
Inundaciones con forma de aplicación y los límites que las responden
Un atacante que imita tu perfil de tráfico es invisible para cualquier filtro de red, por construcción: el trabajo del filtro es dejar pasar las peticiones legítimas, y estas son peticiones legítimas. Lo que las responde es un segundo escudo, más fino, que corre dentro de tu aplicación: límites de tasa, topes de conexiones y timeouts que hacen cara la paciencia abusiva. Nada de esto necesita infraestructura nueva; necesita una tarde de configuración y la disposición a rechazar de vez en cuando a un usuario real que durante una hora se comporta como un bot.
nginx hace explícita la forma. Una directiva limit_req_zone define una tasa con clave — peticiones por minuto por IP, por ejemplo — y limit_req la aplica por location; limit_conn acota las conexiones simultáneas desde una misma dirección. La documentación oficial del módulo cubre ambos, incluidos los parámetros de burst y delay que evitan que el acelerador se sienta como un muro. El mismo patrón existe en todas partes: el mod_reqtimeout de Apache cierra la ventana del slowloris con timeouts sobre peticiones a medio escribir. El mecanismo es aburrido a propósito: un contador con un veredicto.
La colocación de la caché hace la mitad del trabajo gratis. El cacheo HTTP, especificado en la RFC 9111, permite que una página generada responda a diez mil lectores, lo que convierte una inundación de cache-miss en una cuestión de capacidad que sí puedes dimensionar. Pon la caché delante, marca la personalización con tiempos de vida cortos, y una inundación que antes llegaba a la base de datos muere en el borde. Los operadores de WordPress deberían tratar xmlrpc.php y el endpoint de login como lo primero al que poner límite de tasa, porque es lo primero con lo que practican los atacantes.
Cuando la carga desborda un VPS — una API con clientes de verdad, una comunidad que no tolera caché obsoleta —, la salida de emergencia es el metal con control fuera de banda. Compra el dedicado Forge a $49 de lista ($39.20 en término anual): IPMI te permite reimagenar desde el navegador una máquina bloqueada en vez de abrir un ticket, y el array de 2 x 1 TB NVMe absorbe un hot set más grande. El error a evitar es ajustar los límites tan estrechos que los usuarios reales los activen: registra primero los veredictos y fija los techos por encima de tu pico legítimo observado. Esa frontera es exactamente donde empieza la reducción de superficie.
Reduce la cara que presentas
La mitigación más barata no es un filtro: son menos puertas abiertas. Cada servicio a la escucha es una dirección que un atacante puede inundar, sondear o donde puede entrar, y la mayoría de los servidores ejecutan muchos más de los que su aplicación requiere. Antes de gastar dinero en capacidad, enumera qué mira realmente a internet; un endpoint VPN o un servidor de juego tras una whitelist de la comunidad presentan una cara mucho más estrecha que una instalación por defecto, y una cara estrecha priva a las inundaciones de la cobertura de apariencia legítima que necesitan para ser efectivas.
Empieza con un inventario honesto. ss -tlnp lista todos los sockets a la escucha; compáralo con lo que la aplicación realmente necesita y cierra el resto. Deniega por defecto la entrada con nftables o ufw default deny incoming, y luego reabre puertos de uno en uno, servicio a servicio, anotando por qué existe cada uno. Saca los planos de administración de la vista pública donde puedas: una base de datos atada a localhost no puede ser inundada desde fuera, y una interfaz de gestión alcanzable solo por un túnel VPN elimina toda una categoría de exposición en vez de encogerla.
Los dedicados tienen una opción de la que carecen los inquilinos de VPS: un plano de gestión que no comparte en absoluto la ruta de red con la producción. IPMI está en su propia interfaz, de modo que la producción puede ir tras un firewall de un puñado de puertos mientras la consola sigue alcanzable cuando algo se bloquea; el equilibrio está esbozado en la comparación de VPS frente a dedicado. Esa separación explica por qué los servidores de juego con whitelist y los endpoints VPN rinden tan bien en metal: la superficie pública son dos o tres puertos UDP, y la maquinaria de estado detrás de ellos la dimensiona el operador, no un archivo de valores por defecto escrito para un portátil.
El error común es el teatro de higiene: cerrar puertos en el firewall mientras el servicio sigue atado a 0.0.0.0, o endurecer SSH mientras un panel sin parchear escucha en la misma máquina. Vuelve a ejecutar ss -tlnp después de cada despliegue, no solo una vez en la instalación, porque los servicios se van abriendo con el tiempo. La reducción de superficie se acumula con todo lo demás en esta guía: una cara más pequeña necesita menos filtro, menos cola y menos caché. La última clase de carga lleva la idea a su extremo lógico: servicios cuyo trabajo es atraer a propósito el ruido de internet.
Nodos de salida Tor y otras cargas imán
Las cargas más ruidosas son las que más necesitan el escudo, y lo reciben en los mismos términos que todo lo demás. Un nodo de salida de Tor hereda la hostilidad ambiental de toda la red que resume: escáneres, intentos de reflexión e inundaciones de paseo aterrizan en él quiera o no nadie atacar al operador. El filtrado también viaja con el plan aquí; lo que cambia es el papeleo, porque un rol que genera quejas por diseño se aprovisiona bajo petición con un contacto de abuso adjunto. El rol de relay es la prueba de estrés de todo lo que esta página afirma.
El rol de salida es una petición, no un interruptor de producto: pides el relay, adjuntas un contacto de abuso, y la máquina llega con el filtrado activado como cualquier otra. La documentación del Tor Project repasa las responsabilidades del operador de salida en el lado del software; el lado de la plataforma se mantiene aburrido: tránsito sin límite de tráfico, sin registros de contenido ni de tráfico de invitados, y metadatos de conexión que caducan en menos de 24 horas. La elección de ubicación sigue la misma lógica que cualquier carga próxima a la privacidad: Islandia y Suiza llevan primas publicadas (+20% / +35%) y leyes que moldean cómo se responde a una queja.
En la propia máquina, torrc es donde se estrecha la cara. Un ExitPolicy reducido encoge los rangos de puertos que el relay llevará, AccountingMax acota el presupuesto diario de bytes, y el puerto de control queda atado a localhost, donde nada externo puede alcanzarlo. Una salida que solo maneja unos pocos rangos de puertos presenta una cara mucho más estrecha que una salida completa, y cada puerto que rechazas es una clase de abuso que nunca llega para ser denunciada.
Dónde se rompe: montar un relay sin el contacto de abuso y descubrir después que el proceso de abuso de la plataforma necesita a dónde enrutar. El contacto no es decoración: es la dirección a la que fluyen las quejas, y un relay aprovisionado sin uno invita al manejo manual que querías evitar. Aquí está también la frontera honesta de la promesa de la plataforma: el filtro protege al relay, la ley de la ubicación del centro de datos gobierna las quejas, y tu configuración gobierna todo lo demás. Toca montar las piezas en orden.
El VPS con protección DDoS, en el orden de ejecución
Empieza clasificando el servicio que piensas ejecutar, porque la clasificación decide todo lo que viene después. Un servidor de juego con whitelist, un endpoint VPN y un blog de WordPress enfrentan inundaciones de formas muy distintas, y el catálogo responde a las tres con el mismo filtrado. Configura el plan, el término y una de las doce ubicaciones, paga la factura en cripto, y el VPS hace imagen un minuto después con el filtrado L3/L4 ya activado: no hay interruptor que buscar ni ticket que abrir.
Antes de que llegue el primer usuario real, endurece el kernel. Sube nf_conntrack_max, tcp_max_syn_backlog y somaxconn a valores que tu RAM pueda pagar, activa las SYN cookies y confirma que el listen backlog de la aplicación coincide con la cola que acabas de ensanchar. Luego inventaría los procesos a la escucha con ss -tlnp, deniega la entrada por defecto y reabre solo los puertos que el servicio necesita. Quince minutos de este trabajo deciden cuánto del residuo volumétrico — la basura que sobrevive al scrubbing de upstream — ignora tu máquina por sí sola.
A continuación, coloca las defensas con forma de aplicación. Define un limit_req_zone, fija techos con limit_conn, ajusta los timeouts de lectura y de cabeceras, y pon una caché delante de todo lo que sea caro de renderizar; si la superficie es solo web, una CDN delante de HTTP convierte las inundaciones de peticiones en aciertos de caché. Registra los veredictos durante una semana antes de estrechar, para que los límites que fijes reflejen a usuarios reales y no suposiciones. Esta es la mitad de la defensa DDoS que la plataforma no puede hacer por ti, y es la mitad que decide los desenlaces L7.
Luego dimensiona para el residuo. Contrasta el puerto que trae tu plan — 1 Gbps en la entrada, hasta 25 Gbps en Monolith — con el tráfico limpio que el servicio realmente necesita, y recuerda que un puerto más grande es una compra de crecimiento, no una compra contra ataques. Si la carga atrae ataques dirigidos deliberados, prefiere una cara estrecha: una whitelist, una política de salida reducida o la gestión detrás de una VPN. En el metal, verifica el acceso IPMI desde el primer día, para que una máquina bloqueada sea tu reimagen y no un ticket.
Por último, ensaya. Haz pruebas de carga a los límites, revisa lo que los filtros registraron durante la prueba, y escribe el orden en un sitio donde de verdad vayas a mirar. La secuencia es: clasificar, aprovisionar, endurecer el kernel, acotar la aplicación, dimensionar el tubo, estrechar la cara, ensayar. Una defensa que nunca has ejecutado es un diagrama, no una defensa, y la inundación es un mal momento para leer el manual por primera vez.
¿La protección DDoS va realmente incluida y no es un extra de venta?
Sí: el filtrado L3/L4 viene activado en todos los SKU de VPS y dedicados, sin cuota por IP y sin ticket que solicitar. La única excepción, en sentido inverso, es el scrubber L3/L7 de Monolith, el único nivel donde el scrubbing de capa de aplicación está integrado en el propio uplink de 25 Gbps.
¿El filtrado bloqueará a mis usuarios legítimos?
El scrubbing volumétrico es estadístico y está ajustado en upstream, así que los navegadores, las API y los clientes de juego pasan sin ser molestados. Lo que no puede juzgar es el abuso con forma de aplicación: un slowloris o una inundación de API de aspecto válido es asunto de tu rate limiting, tus timeouts y tu caché, no de la red.
¿Los nodos de salida Tor reciben protección DDoS?
Sí, en los mismos términos que cualquier servidor, y las salidas atraen más ruido ambiental que casi cualquier otra carga. Las salidas se aprovisionan bajo petición con un contacto de abuso adjunto, ya que el rol genera quejas por diseño y ese contacto es el destino al que se enrutan.
¿Qué pasa si un ataque igualmente satura mi servicio?
Los filtros mantienen vivos el tubo y las tablas de estado, pero una inundación L7 que imita usuarios puede agotar igualmente la aplicación. Revisa los límites de conexión, añade caché, pon HTTP detrás de una CDN y, en los niveles dedicados, usa IPMI para reimagenar la máquina tú mismo si se bloquea.
¿Puedo ampliar la capacidad de filtrado durante un ataque?
No hay ninguna mejora de filtro que comprar en pleno ataque, porque el scrubbing es una propiedad de la red, no una función del plan. Lo que puedes cambiar es tu lado: subir los límites de las colas del kernel, ensanchar o estrechar los límites de la aplicación, o poner HTTP detrás de una CDN mientras el incidente sigue en curso.
¿Listo para lanzar?
Configura el servidor —VPS, almacenamiento o bare metal—, crea la contraseña y paga la factura que sigue.